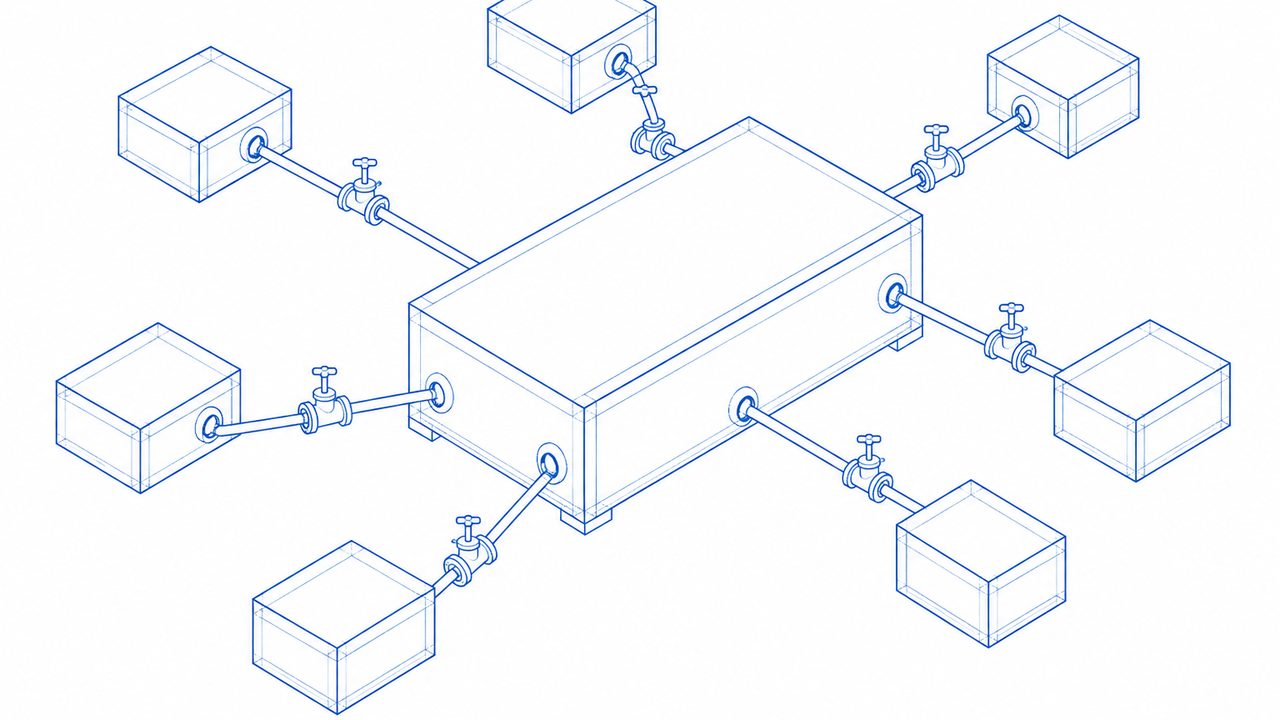
基幹システム(会計・販売管理・生産管理など)にAIエージェントを接続するときは、「読み取り専用から始める」が設計の大原則です。書き込み権限を与えるのは、読み取りで動作を十分に検証してからです。順番を逆にすると、本番データへの意図しない影響が回復困難な形で残ります。
なぜ基幹システムは慎重に扱うべきか
基幹システムのデータは企業運営の中核であり、誤った書き込みや削除は影響が即座かつ広範囲に及びます。AIエージェントは自然言語の曖昧さをそのまま引き継ぎます。「先月の注文をキャンセルして」という一文が、意図した1件ではなく全件に作用する可能性があります。エージェントに外部データを処理させる場合は、間接プロンプトインジェクションのリスク(本シリーズ関連記事参照)も基幹データが絡む文脈では影響が大きくなります。
段階的な接続設計:5ステップ
ステップ1: 読み取り専用で始める
まずはデータを参照するだけの権限でエージェントを動かします。受注一覧の取得・在庫照会・売上集計など、書き込みを伴わないタスクで動作を検証します。この段階でエラー率・コスト・レスポンス品質を測定し、本番環境への接続可否を判断します。
ステップ2: 書き込みは承認付きで
書き込み操作(発注・登録・更新)をエージェントに許可する場合は、実行前に人間の承認ステップを必ず挟みます。エージェントが「この操作を実行していいですか?」と提示し、担当者がOKを出して初めて実行される設計です。承認履歴はログとして残します。
ステップ3: 外部送信は別権限で管理
基幹データを外部サービス(メール・チャット・外部API)に送り出す操作は、「外部送信権限」として書き込み権限とは別に定義します。エージェントが持つ権限を役割ごとに分離することで、意図しないデータ流出のリスクを構造的に抑えます。
ステップ4: 監査ログを必須にする
エージェントがどのAPIエンドポイントに・どんなパラメータで・何時にアクセスしたかを記録します。問題が起きたときに追跡できる証拠になるとともに、モデルの挙動を改善するためのデータにもなります。「何が起きたかわからない」は基幹システムでは許容できません。
ステップ5: テスト環境で検証してから本番へ
基幹システムには通常、本番環境とは別のテスト環境があります。エージェントを本番データに触れさせる前に、テスト環境で想定外の動作がないかを検証します。特に「誤ったパラメータを渡したときに何が起きるか」と「複数の操作を連鎖させたとき整合性が保たれるか」を確認してください。
既存APIの有無で選択肢が変わる
基幹システムへの接続方法は、既存のAPI整備状況によって現実的な選択肢が変わります。
| 状況 | 選択肢 |
|---|---|
| 基幹システムにAPIが公開されている | MCP・Function calling で直接接続 |
| APIはないがRPAで自動化できる操作がある | RPA(画面操作の自動化)とエージェントを組み合わせる |
| APIもRPA対応も難しい | CSVエクスポート → エージェント処理 → インポートの非同期フロー |
既存APIが整備されているシステムへの接続は設計が比較的シンプルです。APIが存在しない場合、RPA(Robotic Process Automation)との組み合わせが現実的な選択肢になりますが、画面変更への脆弱性とメンテナンスコストの増加も踏まえた上で判断してください。非同期フロー(エクスポート→処理→インポート)は柔軟性が低い一方、既存システムへの依存が小さく安定性が高い選択肢です。
段階的な接続は遠回りに見えますが、本番でのインシデントを防ぐための最短経路です。
参考
 ORGANIZATION / 2026.09.04
 ADOPTION / 2026.09.01
 REPORT / 2026.06.30
 AGENTS / 2026.08.25
 ROADMAP / 2026.08.04
 NEWS / 2026.07.23
 EVALUATION / 2026.07.07
 KNOWLEDGE / 2026.06.23
 AGENTS / 2026.06.02
 OPERATIONS / 2026.05.19
 CONNECT / 2026.04.28